Четыре проекта на одном сервере: переезд за один день
Как я за один день перенёс личный сайт, syBoard, Attest0 и «Орбиту» на один сервер, сменил секреты и сохранил простой в пределах нескольких минут.
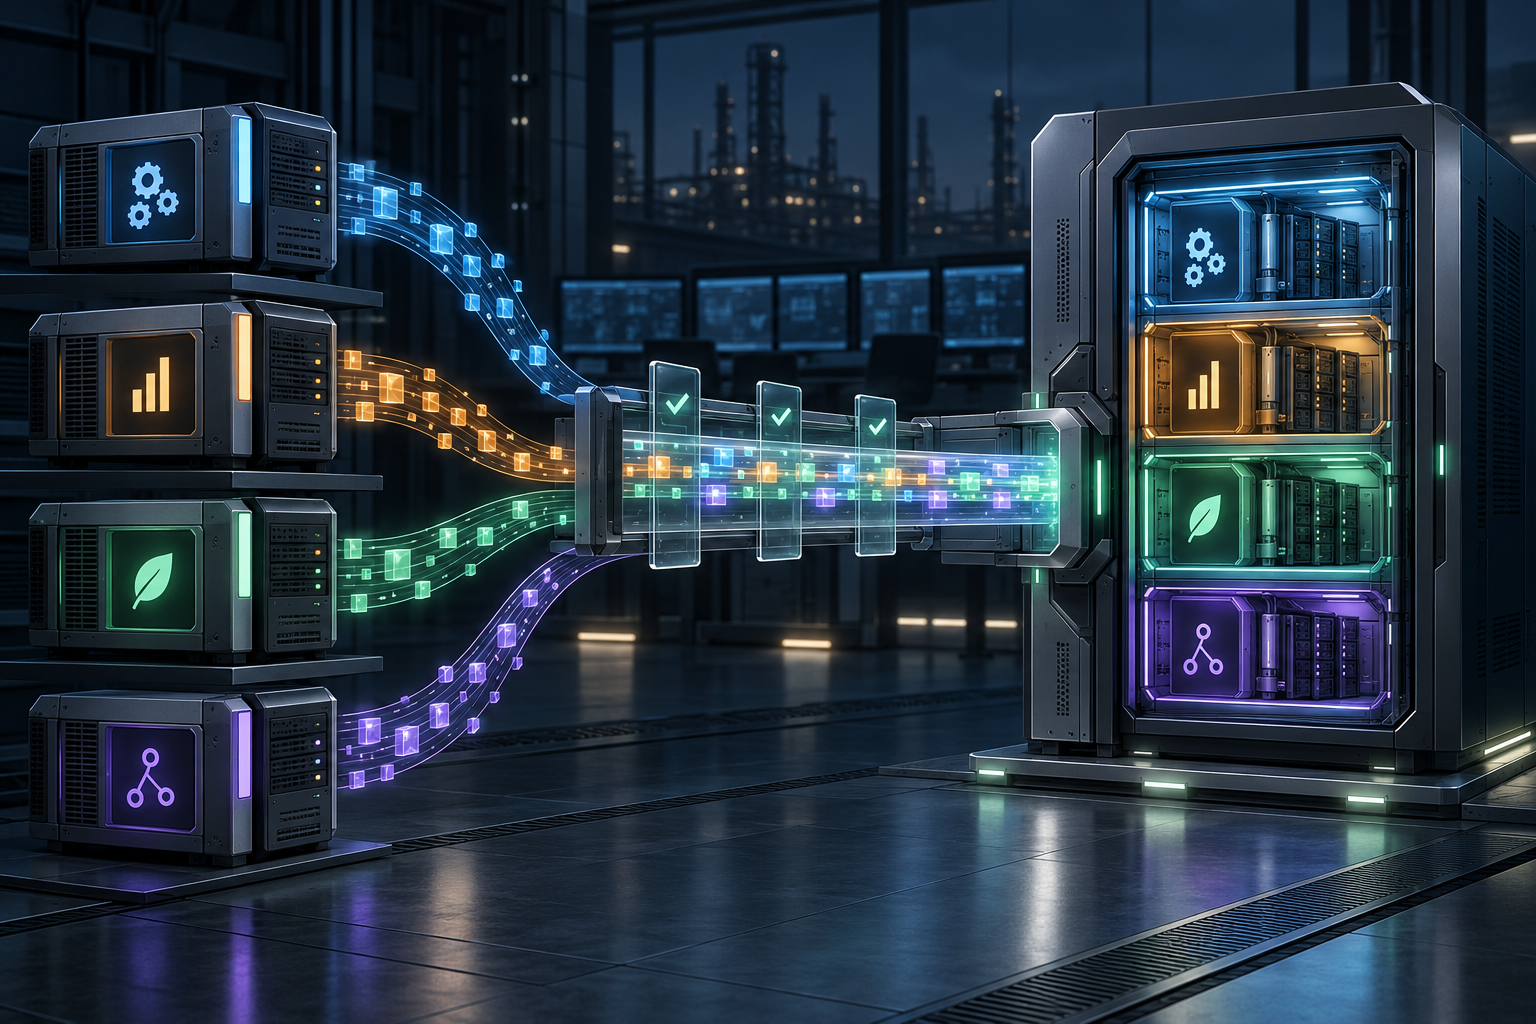
Утром 21 октября я ещё не собирался заниматься переездом. К вечеру личный сайт, syBoard, Attest0 и «Орбита» уже работали на другом сервере.
Причиной стала информация об инциденте безопасности в инфраструктуре FirstVDS. В тот момент поддержка была закрыта. Быстро связаться со специалистами и получить ответы не получилось.
Можно было ждать разъяснений. Но проекты мои, данные мои, ответственность тоже моя. Поэтому решение было простым: переносить всё в тот же день.
Старые серверы нужно было освободить до вечера. Это сразу изменило порядок работы. Времени на красивую схему и долгую подготовку не было. Нужно было быстро понять три вещи: хватит ли нового сервера, можно ли доверять старому окружению и как переключить адреса с минимальным простоем.
Сначала — план переезда
Новый сервер имел четыре ядра и 9,9 ГБ памяти. Первоначальная оценка показывала, что свободного места почти не останется. Самым простым решением было увеличить сервер и заплатить за дополнительный запас.
Я решил сначала посмотреть фактическую нагрузку. Проверил память, процессор, размер баз и объём загруженных файлов на каждом старом сервере.
Результат отличался от предварительной оценки почти вдвое. Все проекты вместе использовали меньше 3 ГБ памяти. После переезда сервер со всеми системными сервисами занимал около 3,6 ГБ. Диск был заполнен на 31%. Одновременно работали 22 контейнера.
Увеличивать сервер не пришлось.
Расчёт с запасом постепенно превращается в расчёт без исходных данных. Запас нужен, но сначала всё-таки стоит измерить нагрузку. На производстве работает то же правило: сначала замер, потом решение.
После замеров стало понятно, что мощности хватит. Дальше нужно было разместить четыре проекта так, чтобы они не мешали друг другу.
Каждый проект получил свою папку, контейнеры и базу. Прикладные данные между проектами не смешиваются. Перезапуск одного приложения не должен затрагивать соседние.
Снаружи у сервера один общий вход. Он принимает запросы, получает сертификаты HTTPS и направляет пользователя в нужный проект. Получилась схема, похожая на проходную предприятия: вход общий, но дальше у каждого участка своя территория.
Резервное копирование, наоборот, объединил. Один сценарий собирает копии всех проектов по расписанию. Они хранятся 14 дней. Дополнительную копию можно забрать на мой компьютер.
До переезда резервные копии уже существовали. Но сам файл копии ещё ничего не гарантирует. Поэтому восстановление заранее проверил на пустой базе. Только после этого начал переносить рабочие данные.
После проверки мощности и резервных копий можно было переходить к самим проектам. Переносил их по очереди, чтобы проблемы одного не остановили остальные.
Проекты переезжали по очереди
Первым — syBoard
Со старого сервера я не переносил приложение целиком. syBoard собрал заново из чистого репозитория. Со старой площадки взял только данные, предварительно их проверив.
Такой порядок выбрал из-за инцидента у провайдера. Старый сервер больше нельзя было считать доверенным источником кода и настроек. На нём могли остаться временные файлы, ручные исправления или изменения, которых нет в репозитории.
Чистая сборка дала понятную точку отсчёта. Если приложение нельзя запустить без содержимого старого сервера, значит часть процесса существует только в чьей-то памяти. Для рабочего проекта это плохая зависимость.
После запуска syBoard восстановил базу, сверил записи и открыл основные страницы. Затем перезапустил проект ещё раз. Именно повторный запуск позже оказался важной проверкой для остальных сервисов.
Следом — Attest0
Attest0 переезжал по той же схеме: чистый код, новая конфигурация, отдельная база и проверенные данные.
Здесь случился самый заметный простой за весь день. В архив с компьютера Mac попали скрытые служебные файлы ._*. На ноутбуке они никому не мешали. Сервер попытался прочитать их как программный код, и приложение не запустилось.
Attest0 был недоступен около трёх-четырёх минут. Лишние файлы удалил, а в сборку добавил автоматическую очистку, чтобы ситуация не повторилась.
Этот эпизод показал разницу между «архив собран» и «на сервер попал правильный архив». Проверять нужно именно тот файл, который будет развёрнут в рабочей среде. Хорошее настроение после сборки в состав проверки не входит.
Для «Орбиты» пришлось менять ключ
Простого копирования для «Орбиты» было недостаточно. Данные хранятся в зашифрованном виде. Старый ключ оставлять было нельзя, а обычная замена ключа сделала бы существующие данные недоступными.
Для перехода подготовил отдельный инструмент. Он открывал данные старым ключом и сразу шифровал новым.
Сначала проверил операцию на копии реальных данных: 541 зашифрованное значение в базе и 18 файлов. После обработки открыл базу и проверил файлы. Только затем запустил перешифрование при рабочем переносе.
Операцию, которую трудно отменить, нужно сначала повторить на копии. Особенно когда она касается шифрования и выполняется в день, который и без того получился насыщенным.
Установочные файлы мобильного приложения со старого сервера я не переносил. Их мог скачать и установить пользователь, поэтому брать такие файлы из недоверенного окружения было нельзя. Их нужно собирать заново из проверенного кода.
Вместе с серверами пришлось заменить доступы
На новом сервере выпустил новые пароли баз, ключи шифрования, ключи доступа и другие секреты проектов. Старые значения не переносил.
После смены секретов завершил старые пользовательские сессии. Зашифрованные токены внешних сервисов очистил, чтобы получить их заново. Пользователям после переезда потребовалось повторно войти в систему.
Одновременно проверил содержимое баз и загруженные файлы. Пятьдесят пользовательских файлов прошли антивирусную проверку. Заражённых не обнаружилось.
Во время ревизии нашлась тестовая учётная запись с правами владельца платформы. Она осталась со времён разработки. Учётную запись удалил вместе с неиспользованными приглашениями и старыми сессиями.
Переезд оказался полезной уборкой. Обычно на неё не хватает времени, потому что всё работает. А потом появляется один день, когда проверить приходится сразу всё.
Чистая схема не означала, что всё пройдёт без ошибок. Несколько проблем появились уже во время переноса. Они и стали самой полезной частью проверки.
Что сломалось по дороге
Успешный импорт оставил пустую базу
Следующая проблема выглядела особенно убедительно: скрипт импорта сообщил, что завершился успешно. Ошибок не было. База при этом осталась пустой.
Одна из команд забрала оставшуюся часть сценария во входной поток. Скрипт остановился раньше времени, но вернул успешный статус.
Команды вынес в отдельные файлы, а ошибки перестал скрывать. После повторного импорта проверил количество записей и открыл несколько объектов в приложении.
Успешное завершение команды ещё ничего не доказывает. После переноса нужно проверить данные и пройти основные пользовательские сценарии.
Первый запуск прошёл хорошо, повторный — уже нет
После пересоздания контейнеров один из проектов ответил ошибкой 502. Общий веб-сервер запомнил внутренний адрес приложения. После перезапуска адрес изменился, а маршрут остался прежним.
Настройку исправил. Теперь веб-сервер повторно определяет адрес приложения каждые пять секунд.
Если бы проверка закончилась после первого запуска, проблема осталась бы до следующего обновления. Поэтому каждый проект прошёл ещё один перезапуск. Система должна не только запуститься, но и спокойно пережить повторный запуск.
Адреса переключал после проверки проектов
Когда приложения заработали на новом сервере, оставалось направить к ним пользователей. Для этого нужно изменить DNS — запись, которая связывает имя сайта с адресом сервера.
DNS обновляется не у всех одновременно. Компьютер пользователя, домашний роутер или интернет-провайдер могут некоторое время помнить старый адрес.
Поэтому порядок был таким:
Запустить проект на новом сервере.
Восстановить и проверить данные.
Подготовить сертификат HTTPS.
Изменить DNS.
Оставить старый сервер пересылать запросы на новый.
Проверить сайт через домашнюю и мобильную сети.
Только после этого выключить старый сервер.
Отдельная проблема возникла с сертификатами. Центр сертификации проверял домен по старому адресу, поэтому новый сервер не мог подтвердить право на него. Проверочные запросы временно направил со старого сервера на новый. После выпуска сертификата поменял основную DNS-запись.
Так пользователи, которые ещё приходили по старому адресу, всё равно попадали в новый проект.
Полноценный переходный период лучше измерять сутками. В этот раз старые серверы нужно было удалить до конца дня. После удаления один сайт некоторое время не открывался у меня самого: ноутбук продолжал помнить прежний адрес.
Это не поломка сайта, а кэш DNS. Обычно проблему уменьшает заранее сниженный TTL — срок хранения адреса. Но не каждая панель регистратора позволяет его изменить. В этот раз пришлось принять риск и проверять доступ из разных сетей.
Переезд проверил то, что считалось исправным
При проверке «Орбиты» обнаружилось, что антивирус работает, но около семи месяцев не обновляет базу сигнатур. Процесс был запущен, контейнер не падал, внешне всё выглядело нормально.
Вероятно, источник обновлений отклонял запросы с адресов хостингов. На новом сервере появился тот же отказ.
Проверка доступности отвечает только на вопрос, запущен ли сервис. Для антивируса важна ещё и дата обновления базы. Переезд не создал эту проблему, но заставил её заметить.
Для syBoard и Attest0 после переноса настроил автоматическую выкладку из GitHub. Ключ каждого проекта может обновить только свой сервис. Доступа к соседним проектам у него нет.
Одна из сборок остановилась на проверке безопасности: в зависимости обнаружилась свежая уязвимость без готового исправления. Это уже отдельная задача, но проверка сделала именно то, для чего была включена. Если контроль никогда не может остановить выпуск, это не контроль.
Результат одного дня
Основной простой измерялся минутами. Самый заметный эпизод произошёл с Attest0 и занял около трёх-четырёх минут. Остальные переключения пользователи могли вообще не заметить благодаря временной пересылке со старых серверов.
К концу дня четыре проекта открывались по прежним адресам. Данные сохранились. Секреты были заменены. «Орбита» работала с новым ключом. Резервные копии создавались по расписанию, а восстановление было проверено до окончательного отключения старых серверов.
Да, этим результатом я доволен. За один день удалось перенести четыре проекта, не потерять данные и удержать простой в пределах нескольких минут. Иногда себя можно и похвалить =)
Несколько слов о FirstVDS и STVDS
Не хочу делать провайдера главным отрицательным персонажем этой истории. После серьёзного инцидента у команды наверняка было много более крупных задач и обращений.
Но со стороны клиента ситуация выглядела просто: поддержка закрыта, быстро связаться со специалистами нельзя, ответы на вопросы получить негде. Поэтому решение о срочном переезде пришлось принимать самостоятельно.
FirstVDS и STVDS дали мне неожиданный повод проверить всю схему целиком — от резервных копий до переключения DNS. За этот практический урок можно сказать спасибо. Повторять его, конечно, не хочется.
Главный вывод относится не только к серверам. Внешний подрядчик может хранить систему, обслуживать инфраструктуру и отвечать на обращения. Но план восстановления, рабочие копии и понимание собственных данных должны оставаться у владельца.
Чек-лист, который остался после переезда
Замерить реальную нагрузку каждого проекта.
Сделать копии и хранить их вне старого сервера.
Восстановить копию на пустой базе до начала переезда.
Брать код из чистого репозитория, а со старого сервера — только проверенные данные.
Заменить пароли, ключи и другие секреты.
Завершить старые сессии и удалить временные доступы.
Проверить количество записей и открыть реальные объекты.
Запустить проект, перезапустить его и проверить снова.
Подготовить HTTPS до смены основного адреса.
Оставить временную пересылку со старого сервера.
Проверить доступ из нескольких сетей.
После переключения ещё раз восстановить резервную копию.
Этот список появился не до переезда, а после него. Поэтому в нём нет теоретических пунктов. Каждый шаг либо помог сохранить данные, либо появился после реальной ошибки.